Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
В Co-Design Bench лучший ИИ-агент полностью выполнил лишь 26,4% задач
08.11.2026
Исследователи Alibaba и университетов проверили десять моделей на реальных запросах по доработке веб-приложений. Лидер выполнил в среднем 69,9% требований, но полностью справился лишь примерно с четвертью задач из специально отобранной сложной выборки.
Исследователи Alibaba и нескольких университетов разработали Co-Design Bench — тест ИИ-агентов, которые вносят изменения в существующие веб-приложения.
В сравнении участвовали модели шести разработчиков: OpenAI (GPT-6 Astra и GPT-5.6 Sol), Anthropic (Claude Opus 5 и Claude Opus 4.8), Alibaba (Qwen3.8-Max-0902 и Qwen3.8-27B), Moonshot AI (Kimi K3), Z.ai (GLM-5.2 и GLM-5.3 Flash) и xAI (Grok 4.6).
В набор вошли 273 задачи с 2331 скрытым критерием приёмки. Они охватывают локальные правки страниц и согласованные изменения в многофайловых приложениях; запросы могут сопровождаться изображениями, аудио, видео и документами. Выборка не случайная: при отборе учитывались сложность, проверяемость и признаки прежних затруднений — например, повторные формулировки просьб и откаты изменений.
Основное сравнение проводилось в одинаковой программной среде управления агентом. Результаты проверяли по исходному коду и работе приложения в браузере. Затем отдельная языковая модель оспаривала положительные оценки, выявляя заглушки, жёстко заданные ответы и недоступные пользователю функции. Наличия нужного обработчика в коде недостаточно, если воспользоваться им через интерфейс нельзя.
Все десять моделей выполняли меньшую долю требований в задачах, где одновременно требовались три-четыре типа изменений — структуры, оформления, интерактивности или содержимого, — чем в задачах с одним-двумя типами правок.
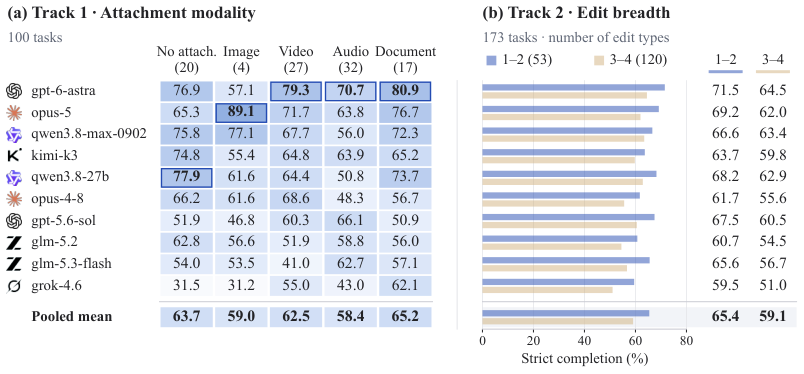
На графике показана доля выполненных отдельных требований, а не полностью решённых задач. Источник: авторы исследования.
Лучший результат среди десяти проверенных моделей показала GPT-6 Astra: агент на её основе полностью выполнил 26,4% задач. При этом средняя доля выполненных требований составила 69,9%: существенная часть работы была сделана, но хотя бы одно условие часто оставалось невыполненным.
У теста есть ограничения: он оценивает выполнение фиксированного запроса без дальнейших уточнений пользователя, а автоматическая проверка не исключает ошибок оценивания. Поэтому результаты характеризуют работу агентов в заданных условиях, а не частоту ручных исправлений во всей практике разработки. Препринт исследования опубликован на arXiv 26 октября 2026 года.
Источник: arxiv.org