Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
В тесте Qwen3-8B энергозатраты на пушту оказались в 179 раз выше, чем на английском
07.11.2026
Исследователи Мичиганского университета сравнили энергопотребление Qwen3-8B на 122 языках. На языках, слабо представленных в обучающих данных, модель чаще ошибалась и генерировала чрезмерно длинные ответы.
Исследователи Мичиганского университета измерили энергозатраты Qwen3-8B компании Alibaba при выполнении 900 одинаковых заданий на 122 языках. Согласно результатам исследования, на английском модель израсходовала 17,6 кДж, а на южном пушту — 3 147 кДж, в 179 раз больше. Работу представили на конференции EMNLP 2026 по обработке естественного языка; университет рассказал о ней 5 ноября.
Для основного эксперимента выбрали Belebele — тест на понимание прочитанного, в котором нужно ответить на вопрос по тексту, выбрав один из четырёх вариантов. Модель просили рассуждать пошагово и затем указывать правильный вариант ответа. Qwen3-8B запускали на графическом ускорителе NVIDIA L40S; его энергопотребление измеряли средствами ML.Energy.
Для русского языка в том же тесте расход энергии был в 2,5 раза выше, чем для английского. Доля правильных ответов составила 90,9% и 94,6% соответственно.
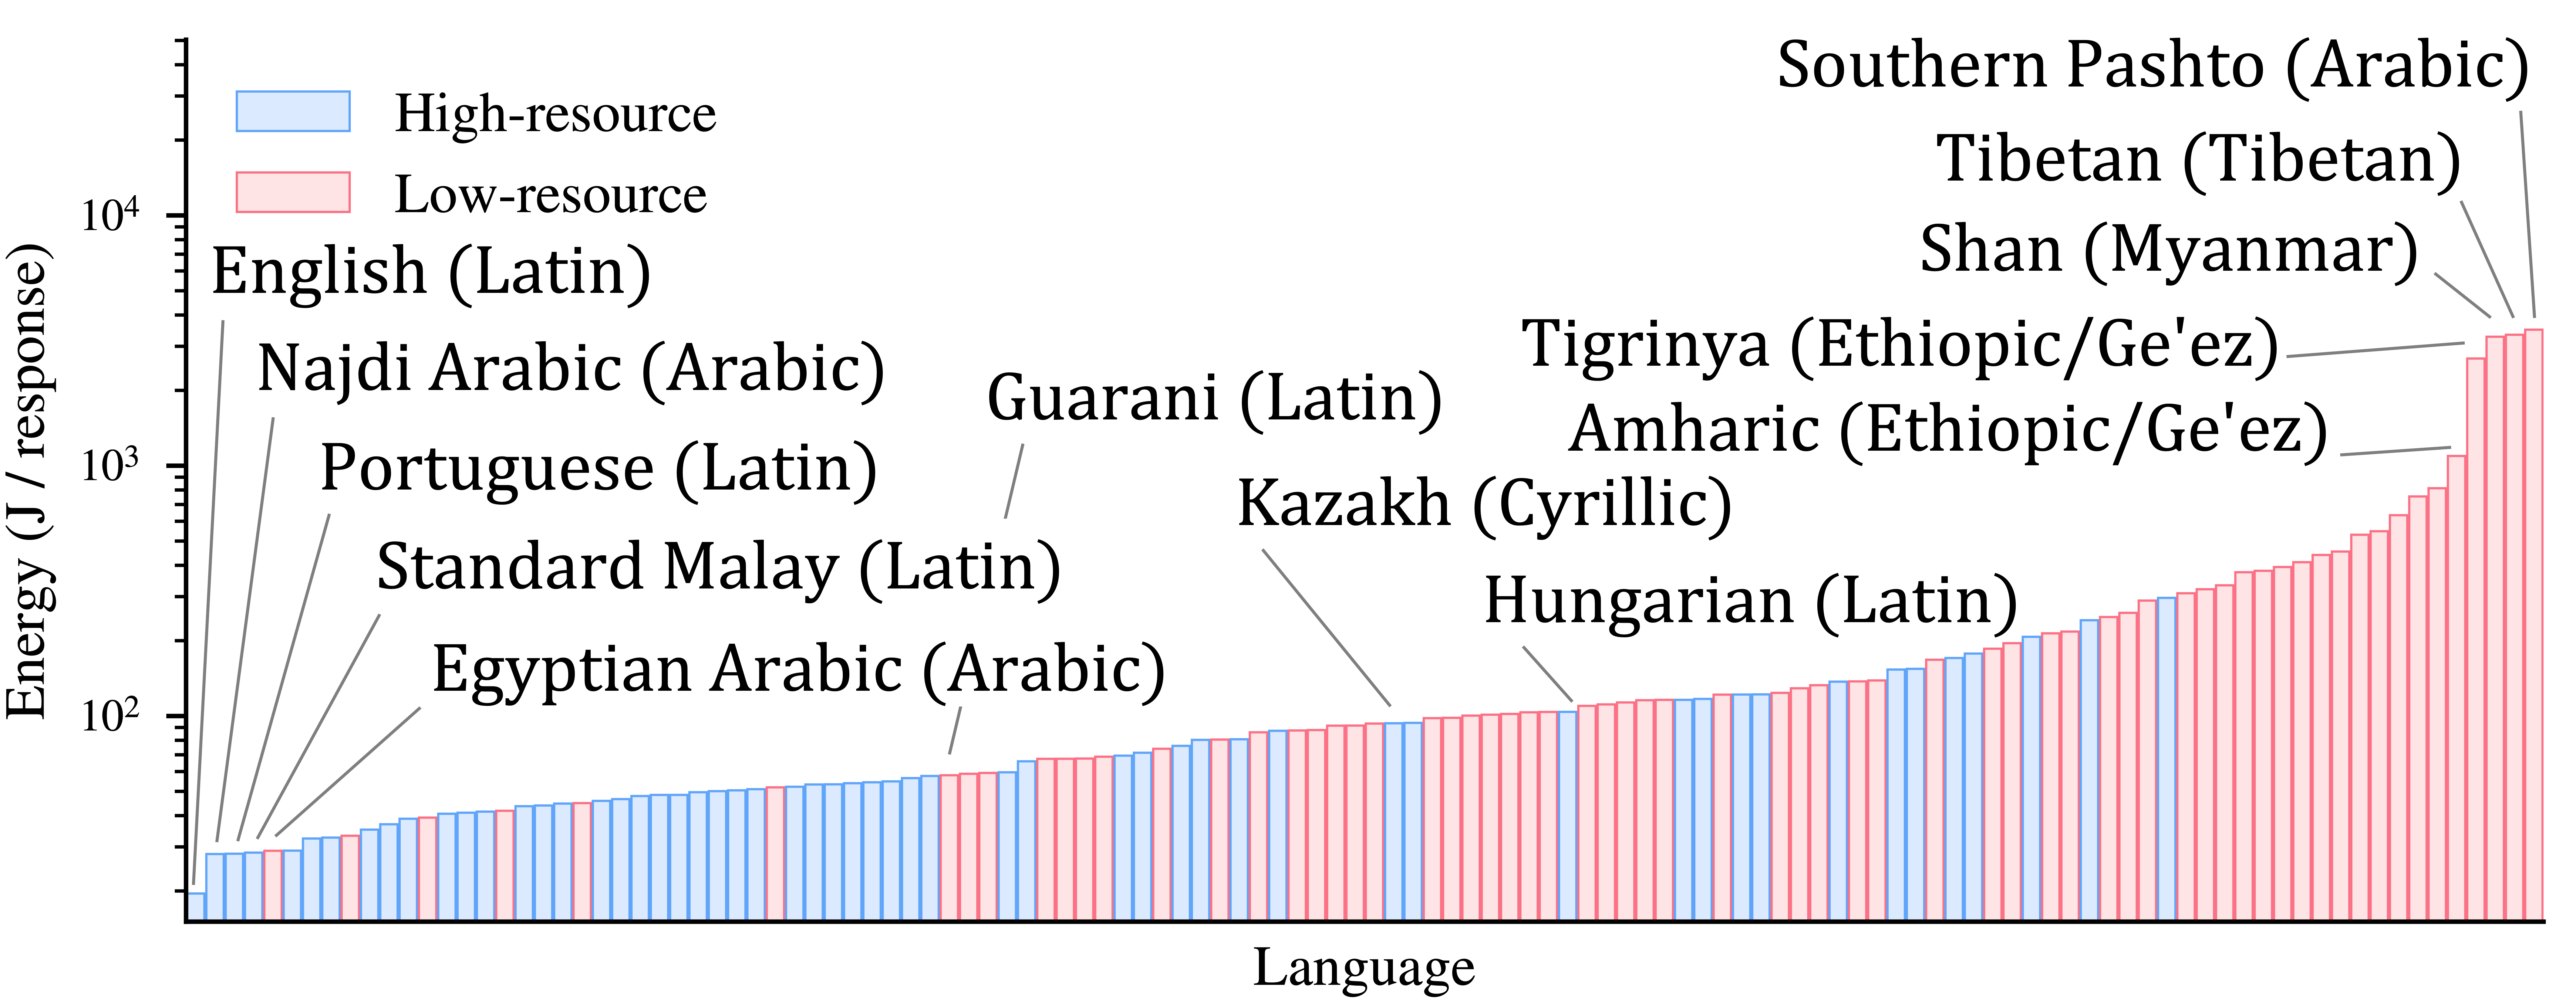
Авторы связывают разрыв с двумя факторами. Токенизаторы, разбивающие текст на фрагменты-токены, хуже приспособлены к некоторым системам письменности. Кроме того, на языках, слабо представленных в обучающих данных, модель часто генерировала длинные, повторяющиеся рассуждения: число токенов в ответе могло превышать английский вариант в 20–25 раз. Их обработка требует больше памяти и вычислений и может снижать число запросов, которые ускоритель обрабатывает одновременно.
Высокие энергозатраты не сопровождались лучшим качеством: на наиболее затратных языках модель обычно ошибалась чаще. Это не доказывает причинную связь между расходом энергии и ошибками. Исследователи связывают обе проблемы с недостаточным представлением этих языков в обучающих данных и токенизаторах.
Дополнительные проверки на восьми языках включали Qwen3-14B и Qwen3-32B, Gemma 3 и Llama 3.1, другой ускоритель — RTX 6000 Pro Blackwell, а также математические и диалоговые задания. Разрыв в энергозатратах сохранялся, но максимум в 179 раз относится к описанному тесту Qwen3-8B.
Избыточная генерация может увеличивать и расходы пользователей: многие сервисы тарифицируют ответы по числу токенов. Авторы предлагают направлять запросы к моделям, оптимизированным для нужного языка, расширять обучающие корпуса и переводить запросы на английский перед обработкой моделью, если качество перевода позволяет.
Источник: ai.engin.umich.edu