Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
NVIDIA Dynamo-Triton получил поддержку инференса TensorRT на нескольких GPU
22.09.2026
В выпуске NVIDIA Dynamo-Triton 26.07 один экземпляр модели TensorRT может использовать несколько GPU и обслуживаться через единый gRPC-интерфейс. В демонстрации с генератором видео Cosmos 3 Nano переход с одного на восемь GPU сократил задержку со 156,6 до 34,2 секунды.
NVIDIA реализовала в Dynamo-Triton 26.07, ранее называвшемся Triton Inference Server, обслуживание многопроцессорных моделей TensorRT. Один экземпляр KIND_MODEL может управлять несколькими GPU, контекстами исполнения, потоками CUDA и средствами коллективного обмена NCCL, тогда как клиент обращается к модели через единую конечную точку gRPC.
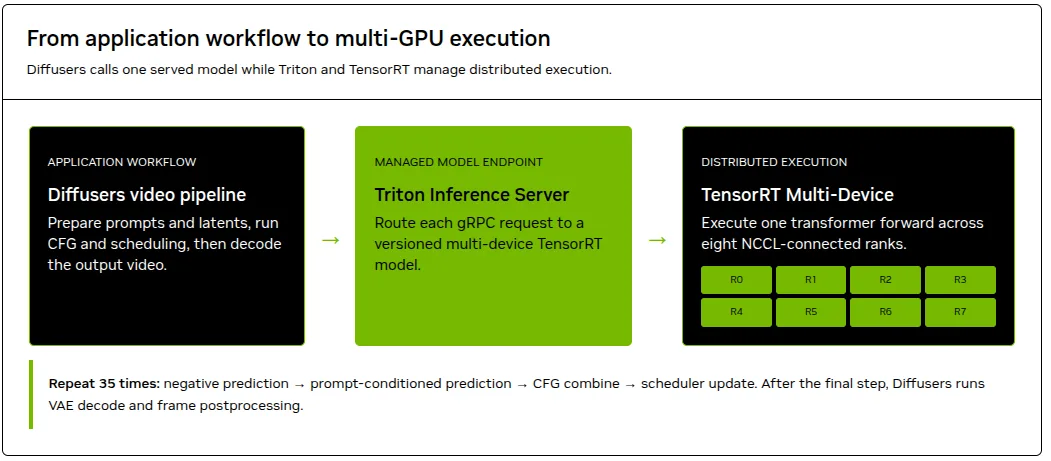
Возможность основана на многопроцессорном инференсе, полностью поддерживаемом начиная с TensorRT 11.0. Распределённый граф компилируется заранее, а конфигурация Dynamo-Triton определяет участвующие GPU и активирует исполнение с использованием NVIDIA Collective Communications Library (NCCL).
Интеграцию проверили на модели генерации видео Cosmos 3 Nano. Её 36-слойный трансформер обрабатывал 44 160 видеотокенов с контекстным параллелизмом Ulysses на одном, двух, четырёх и восьми GPU. Средняя полная задержка генерации снизилась со 156,595 секунды на одном GPU до 34,183 секунды на восьми — ускорение составило 4,58 раза. Время удалённых вызовов трансформера сократилось со 146,192 до 23,993 секунды, или в 6,09 раза.
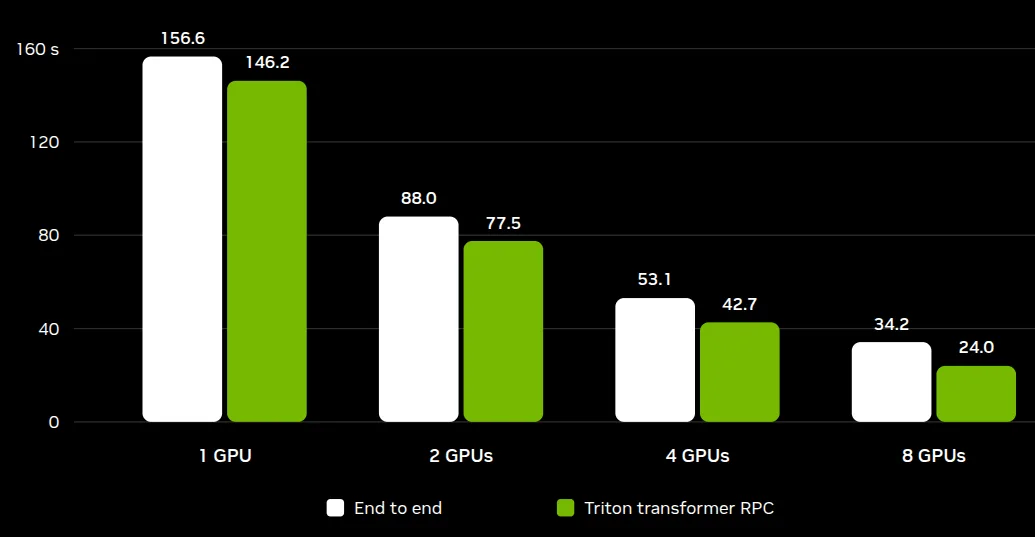
NVIDIA подчёркивает, что испытание оценивало задержку одного задания, но не пропускную способность при параллельных запросах, стоимость генерации и совокупную стоимость владения. Технические подробности и конфигурация приведены в публикации NVIDIA.
Источник: developer.nvidia.com