Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
Google оценила накладные расходы глобальной маршрутизации ИИ-запросов в GKE менее чем в 1%
21.09.2026
Google протестировала мультикластерный GKE Inference Gateway на инфраструктуре из 17 тысяч вычислительных узлов в США и Европе. По данным компании, шлюз сохранил 99,5% пропускной способности прямого обращения к локальному кластеру, а переход с одного кластера на три почти втрое увеличил производительность при успешности запросов около 99,9%.
Google опубликовала результаты испытаний глобальной маршрутизации запросов к большим языковым моделям через мультикластерный GKE Inference Gateway. Тестовая инфраструктура включала 17 тысяч вычислительных узлов в трех регионах Google Kubernetes Engine (GKE): двух в США и одном в Европе.
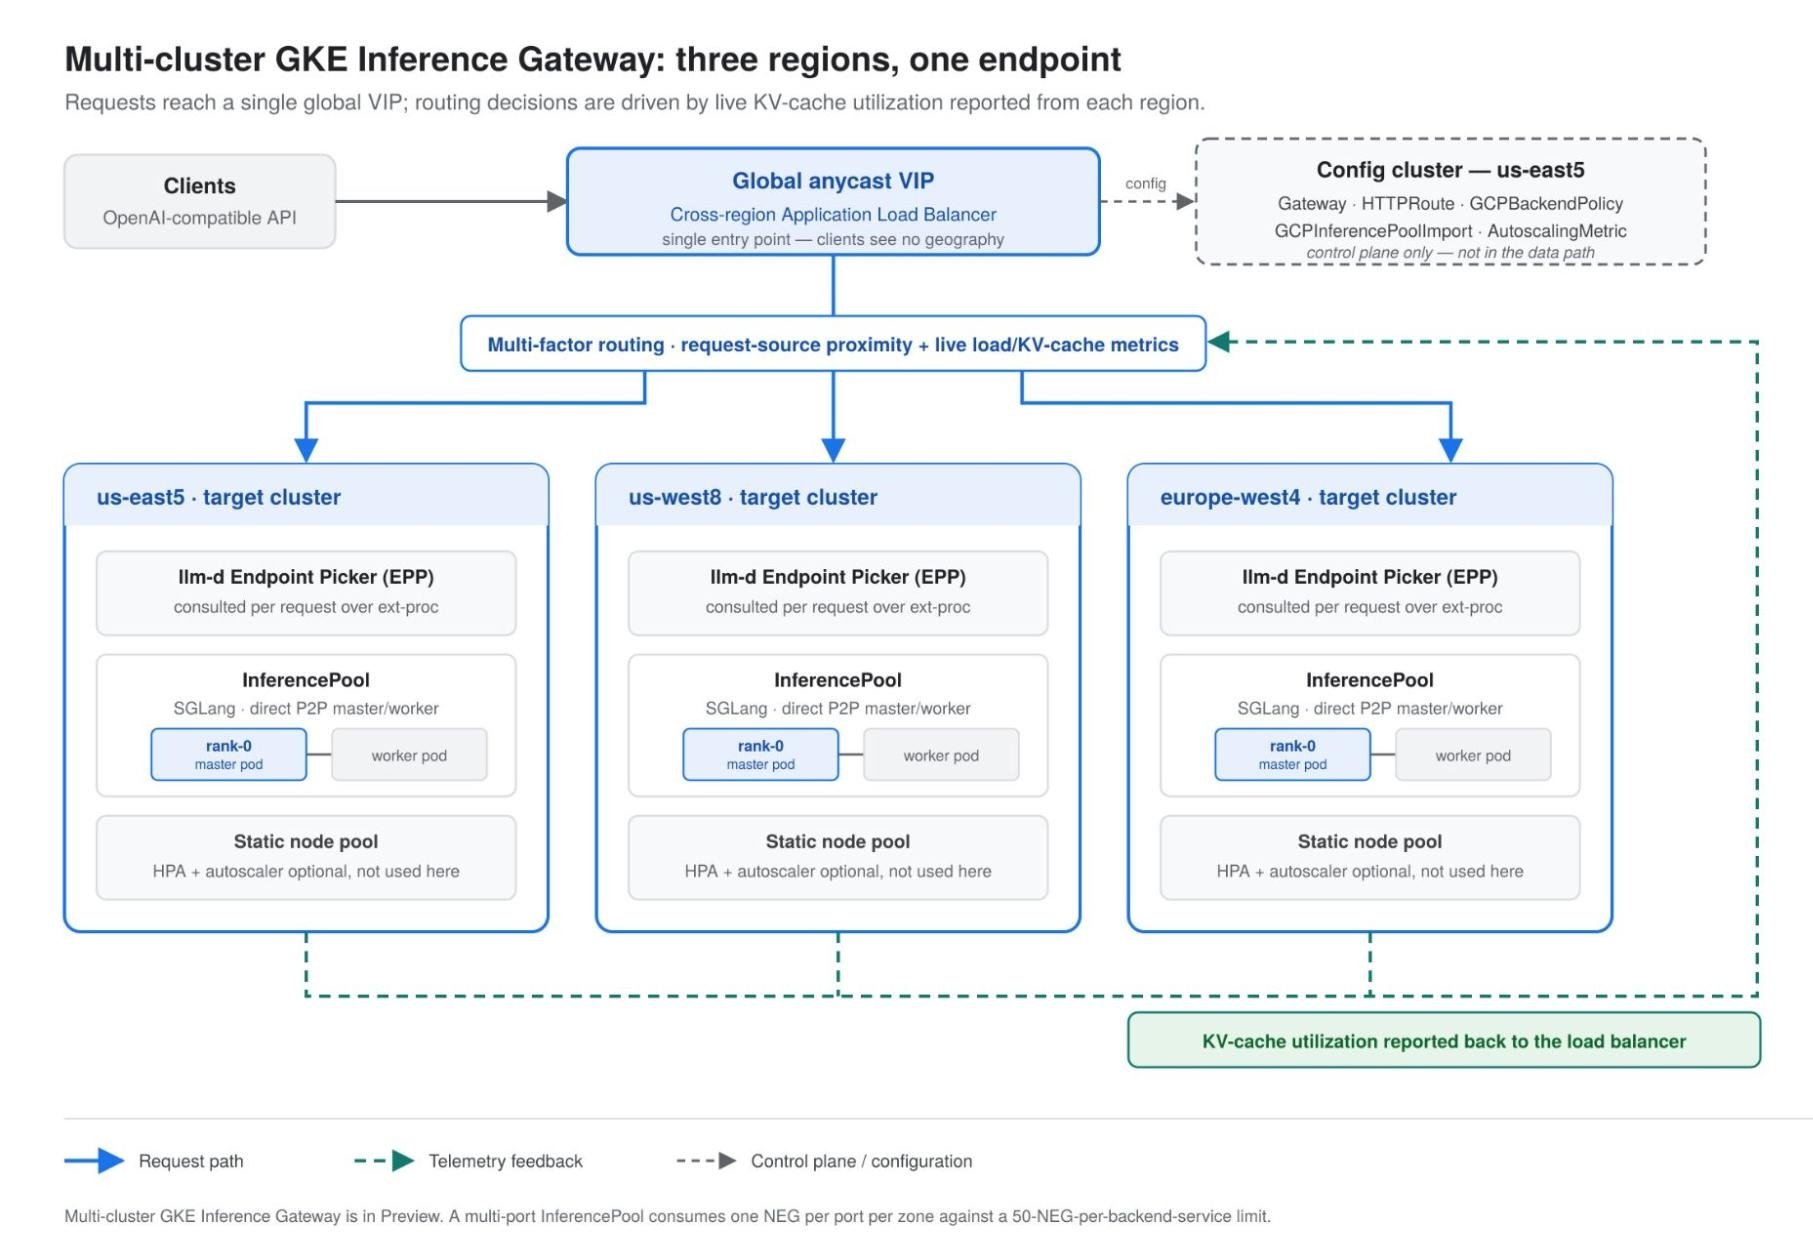
Запросы поступали на единый глобальный IP-адрес, после чего балансировщик выбирал регион по текущей нагрузке. Endpoint Picker Proxy получал от систем инференса данные об использовании KV-кэша — памяти, в которой сохраняются ключи и значения механизма внимания модели. Когда загрузка кэша в основном регионе превышала установленный в тесте порог 40%, новые запросы автоматически перенаправлялись в другой доступный регион.
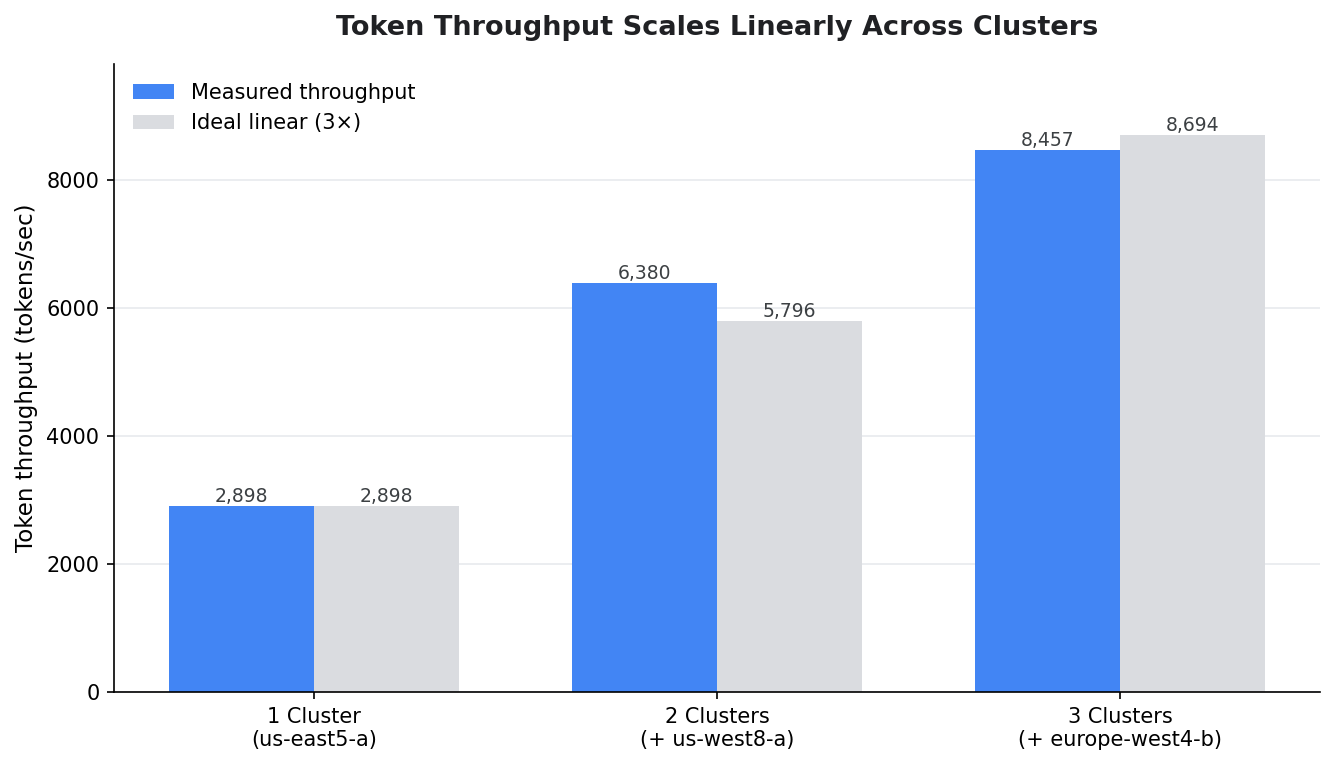
По измерениям Google, добавление глобального шлюза позволило сохранить 99,5% пропускной способности прямого обращения к локальному кластеру. При увеличении числа кластеров с одного до трех скорость обработки выросла с 0,72 до 2,10 запроса в секунду, а производительность по токенам — с 2898 до 8457 токенов в секунду. Доля успешно выполненных запросов во всех конфигурациях составляла от 99,87% до 99,95%.
Для испытаний использовалась не названная компанией модель архитектуры Mixture of Experts и фреймворк SGLang. Глобальное распределение трафика выполнял GKE Inference Gateway, а внутреннюю маршрутизацию с учетом состояния памяти — LLM-d. Google заявляет, что архитектура не привязана к конкретной модели, среде инференса или типу ускорителя и может работать как с GPU, так и с TPU. Опубликованные показатели относятся к конфигурации и нагрузке, выбранным самой компанией.
Источник: cloud.google.com