Проект ЦИТадель
Обзоры • курсы • практикумы
Не «что нажать», а «как устроено»
Alibaba выпустила Qwen-Image-2.1 с открытыми весами и 7-миллиардным генератором
20.09.2026
Команда Qwen представила модель Qwen-Image-2.1 для генерации и редактирования изображений с поддержкой разрешения 2K, прозрачности RGBA и до десяти референсов. Alibaba заявляет о превосходстве над большинством протестированных закрытых моделей, однако независимых оценок пока нет. Веса доступны только для некоммерческих исследований и тестирования.
Команда Qwen компании Alibaba выпустила Qwen-Image-2.1 — модель с открытыми весами, объединяющую генерацию изображений по тексту и редактирование. Её визуальный компонент представляет собой 32-слойный диффузионный трансформер DiT с 7 млрд параметров; для обработки инструкций и референсных изображений используется отдельный кодировщик Qwen3-VL 8B.
Модель нативно создаёт изображения разрешением до 2K, включая файлы RGBA с прозрачным фоном. Она принимает до десяти референсов одновременно, позволяет задавать локальные изменения с помощью масок, окружностей и нарисованных пометок, а также повторно использует KV-кеш входных данных на последовательных шагах генерации.
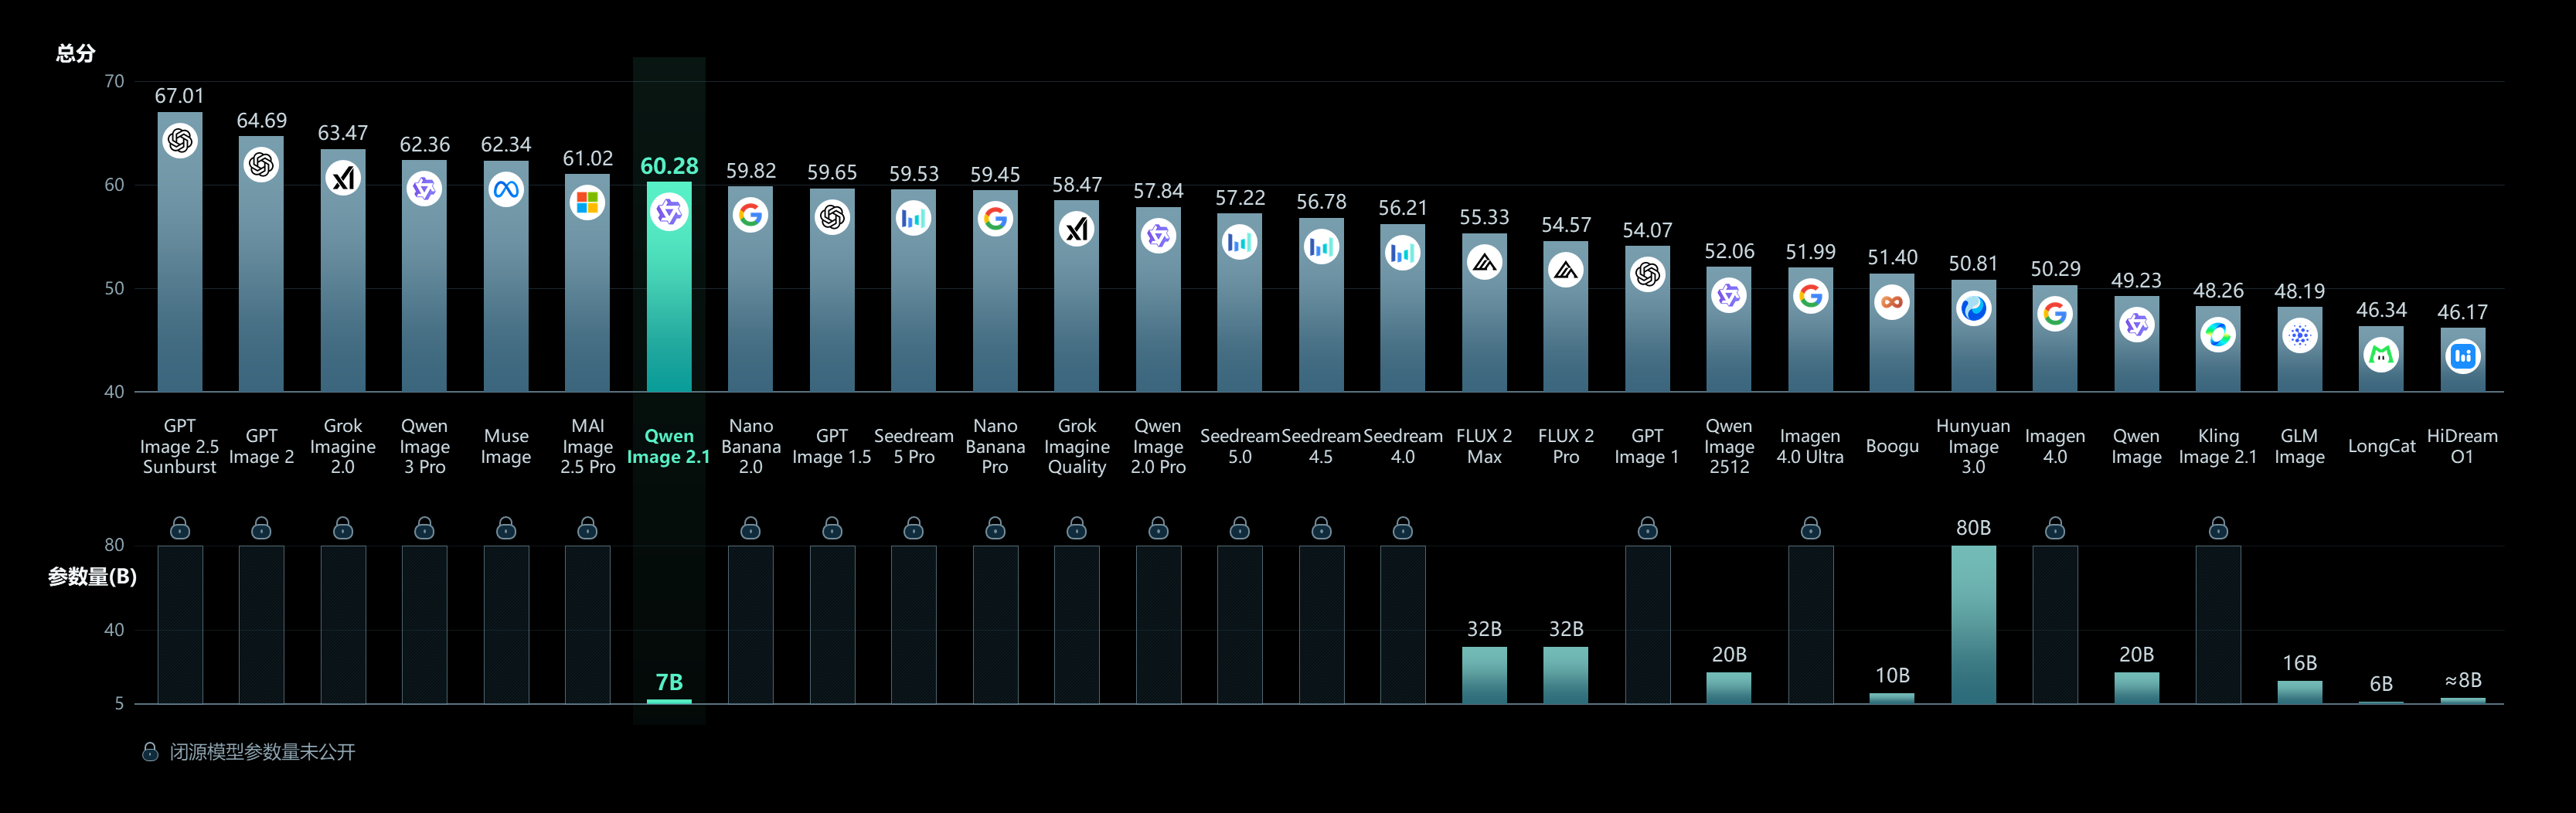
По внутреннему бенчмарку Qwen визуальный компонент Qwen-Image-2.1 опередил большинство участвовавших в сравнении закрытых моделей. Эти результаты опубликованы разработчиками и пока не подтверждены независимым тестированием.
Веса модели размещены на Hugging Face и ModelScope, а код и инструкции — на GitHub. Поддержка Qwen-Image-2.1 уже добавлена в Diffusers, ComfyUI, vLLM-Omni и SGLang. Исследовательская лицензия разрешает использование весов только в некоммерческих целях; для коммерческих проектов требуется отдельное соглашение с Qwen.
Источник: qwen.ai