Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
Inception выпустила диффузионную LLM Mercury 3 со скоростью более 1000 токенов в секунду
21.10.2026
Компания Inception представила Mercury 3 — большую языковую модель, которая итеративно формирует несколько токенов параллельно. Разработчик заявляет скорость 1068 токенов в секунду на ускорителях NVIDIA, контекстное окно на 1 млн токенов и совместимость с API OpenAI.
Компания Inception 19 октября представила Mercury 3 — диффузионную большую языковую модель (dLLM). В отличие от авторегрессионных моделей, строящих ответ последовательно по одному токену, она итеративно уточняет сразу несколько токенов.
По измерениям разработчика, Mercury 3 генерирует 1068 токенов в секунду на графических ускорителях NVIDIA. Контекстное окно модели составляет 1 млн токенов против 260 тысяч у Mercury 2.5. Точное число параметров не раскрывается, но Inception утверждает, что Mercury 3 более чем в 40 раз крупнее первой версии.
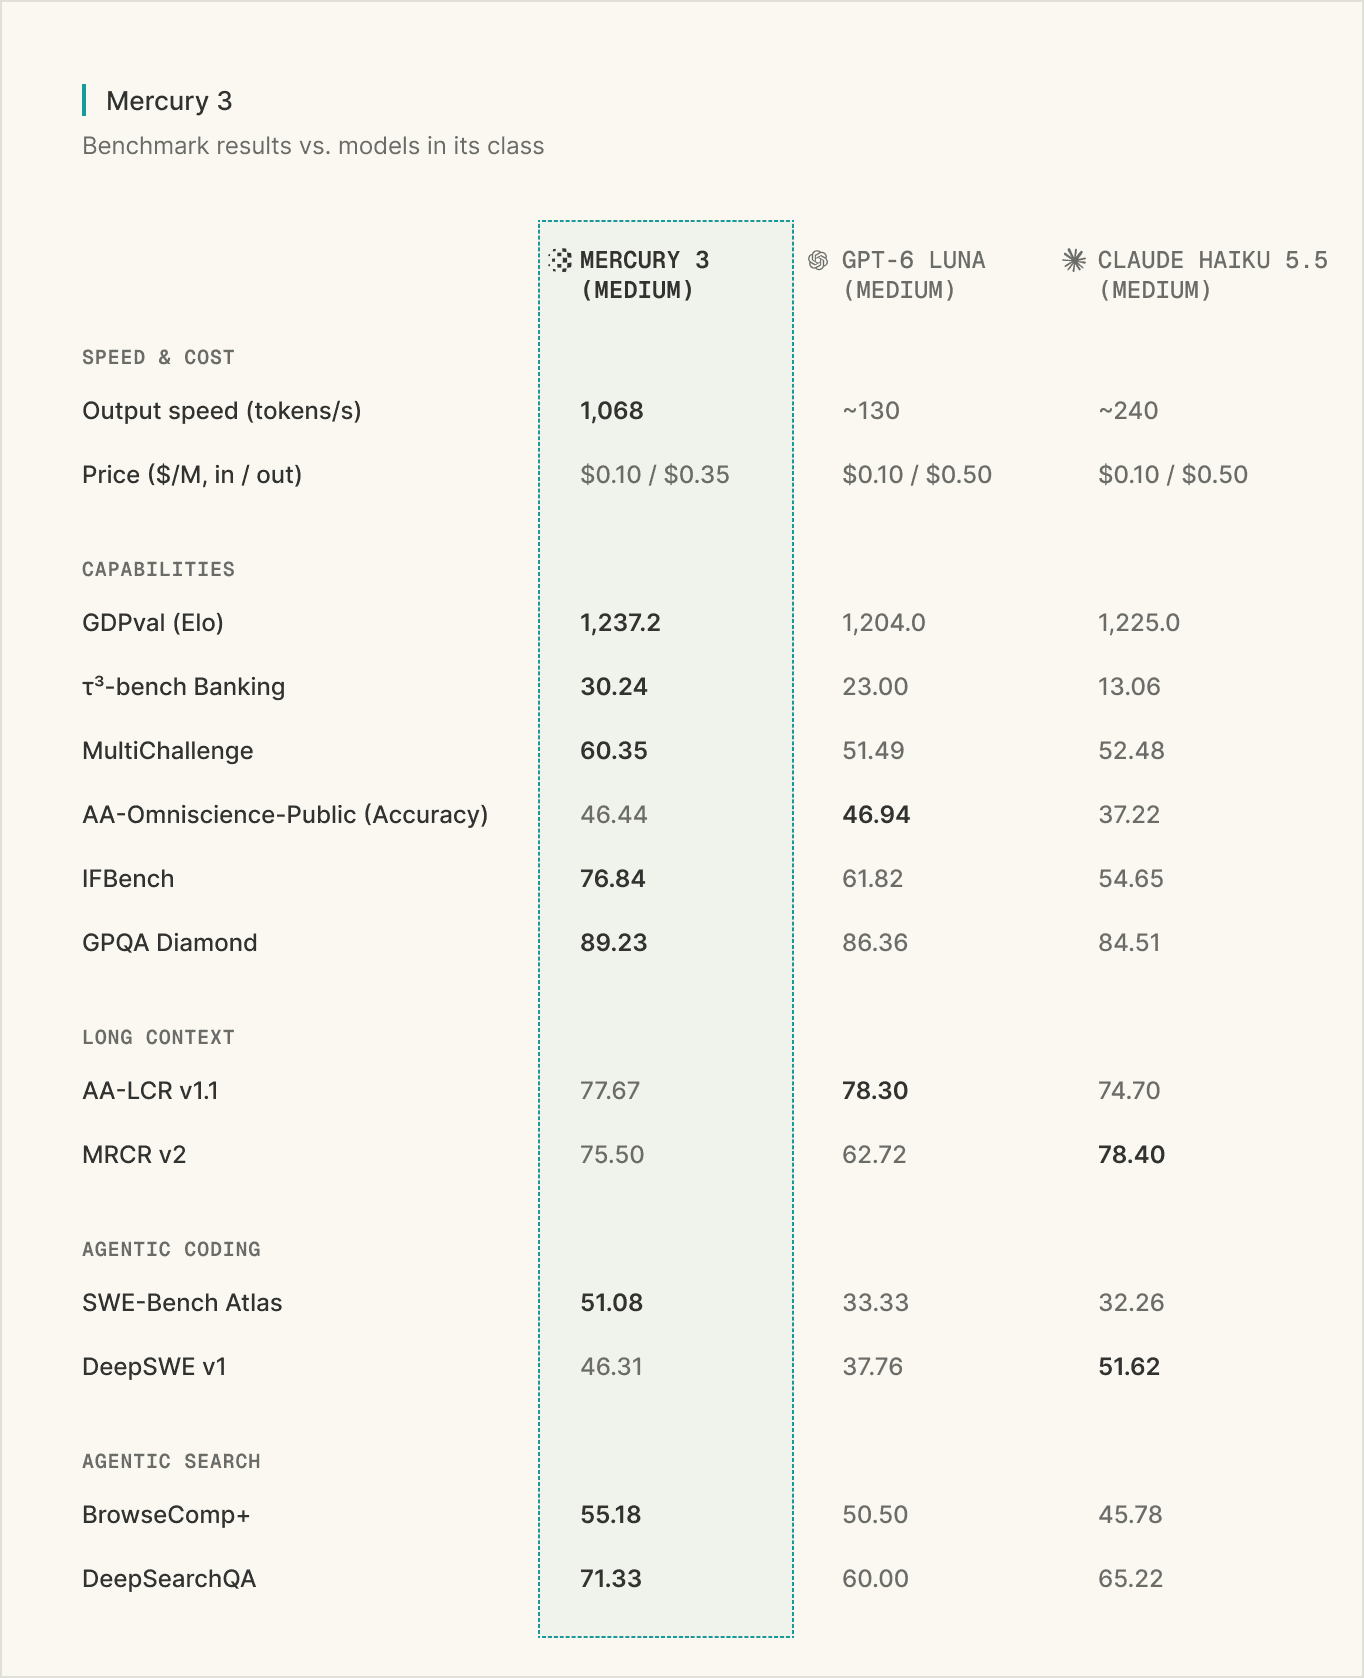
В собственных тестах Inception модель показала сопоставимые или более высокие результаты, чем GPT-6 Luna и Claude Haiku 5.5, по ряду задач, включая программирование, поиск и работу с инструментами. При этом заявленная скорость генерации оказалась в 4–8 раз выше. Сравнение основано на измерениях самой компании.
Mercury 3 доступна через API Inception, а также на платформах OpenRouter, Baseten и Vercel. Модель совместима с форматом API OpenAI. Стандартная стоимость составляет $0,20 за миллион входных и $0,70 за миллион выходных токенов; на этапе запуска действуют сниженные тарифы — $0,10 и $0,35 соответственно.
Источник: inceptionlabs.ai