Новые разделы!
ИИ, квантовые вычисления и много других интересных тем
Исследователи NVIDIA предложили заменить длинный контекст ИИ компактным состоянием
22.11.2026
Исследователи NVIDIA показали, что в проверенных агентных задачах и при обработке больших входных данных частое сжатие истории и выборочное чтение сохраняли качество при значительно меньшем контексте. Авторы предлагают обучать модели работать с компактным текстовым состоянием, но признают, что некоторым задачам длинный контекст всё же может быть полезен.
Группа NVIDIA Research 3 ноября 2026 года опубликовала препринт «You don’t need long context», ставящий под сомнение практику постоянного увеличения контекстных окон языковых моделей. Авторы разделили нагрузки на долгие агентные сценарии, где накапливается история действий, и задачи с большим исходным массивом данных.
В первом случае исследователи периодически сворачивали историю в краткое рабочее состояние, а во втором давали модели инструменты для выборочного чтения файлов вместо загрузки всех данных в запрос. На шести наборах долгих задач и семи наборах с большими входными данными такой подход в большинстве конфигураций сохранял или улучшал качество относительно полной истории или полного ввода, хотя отдельные тесты показали небольшое ухудшение.
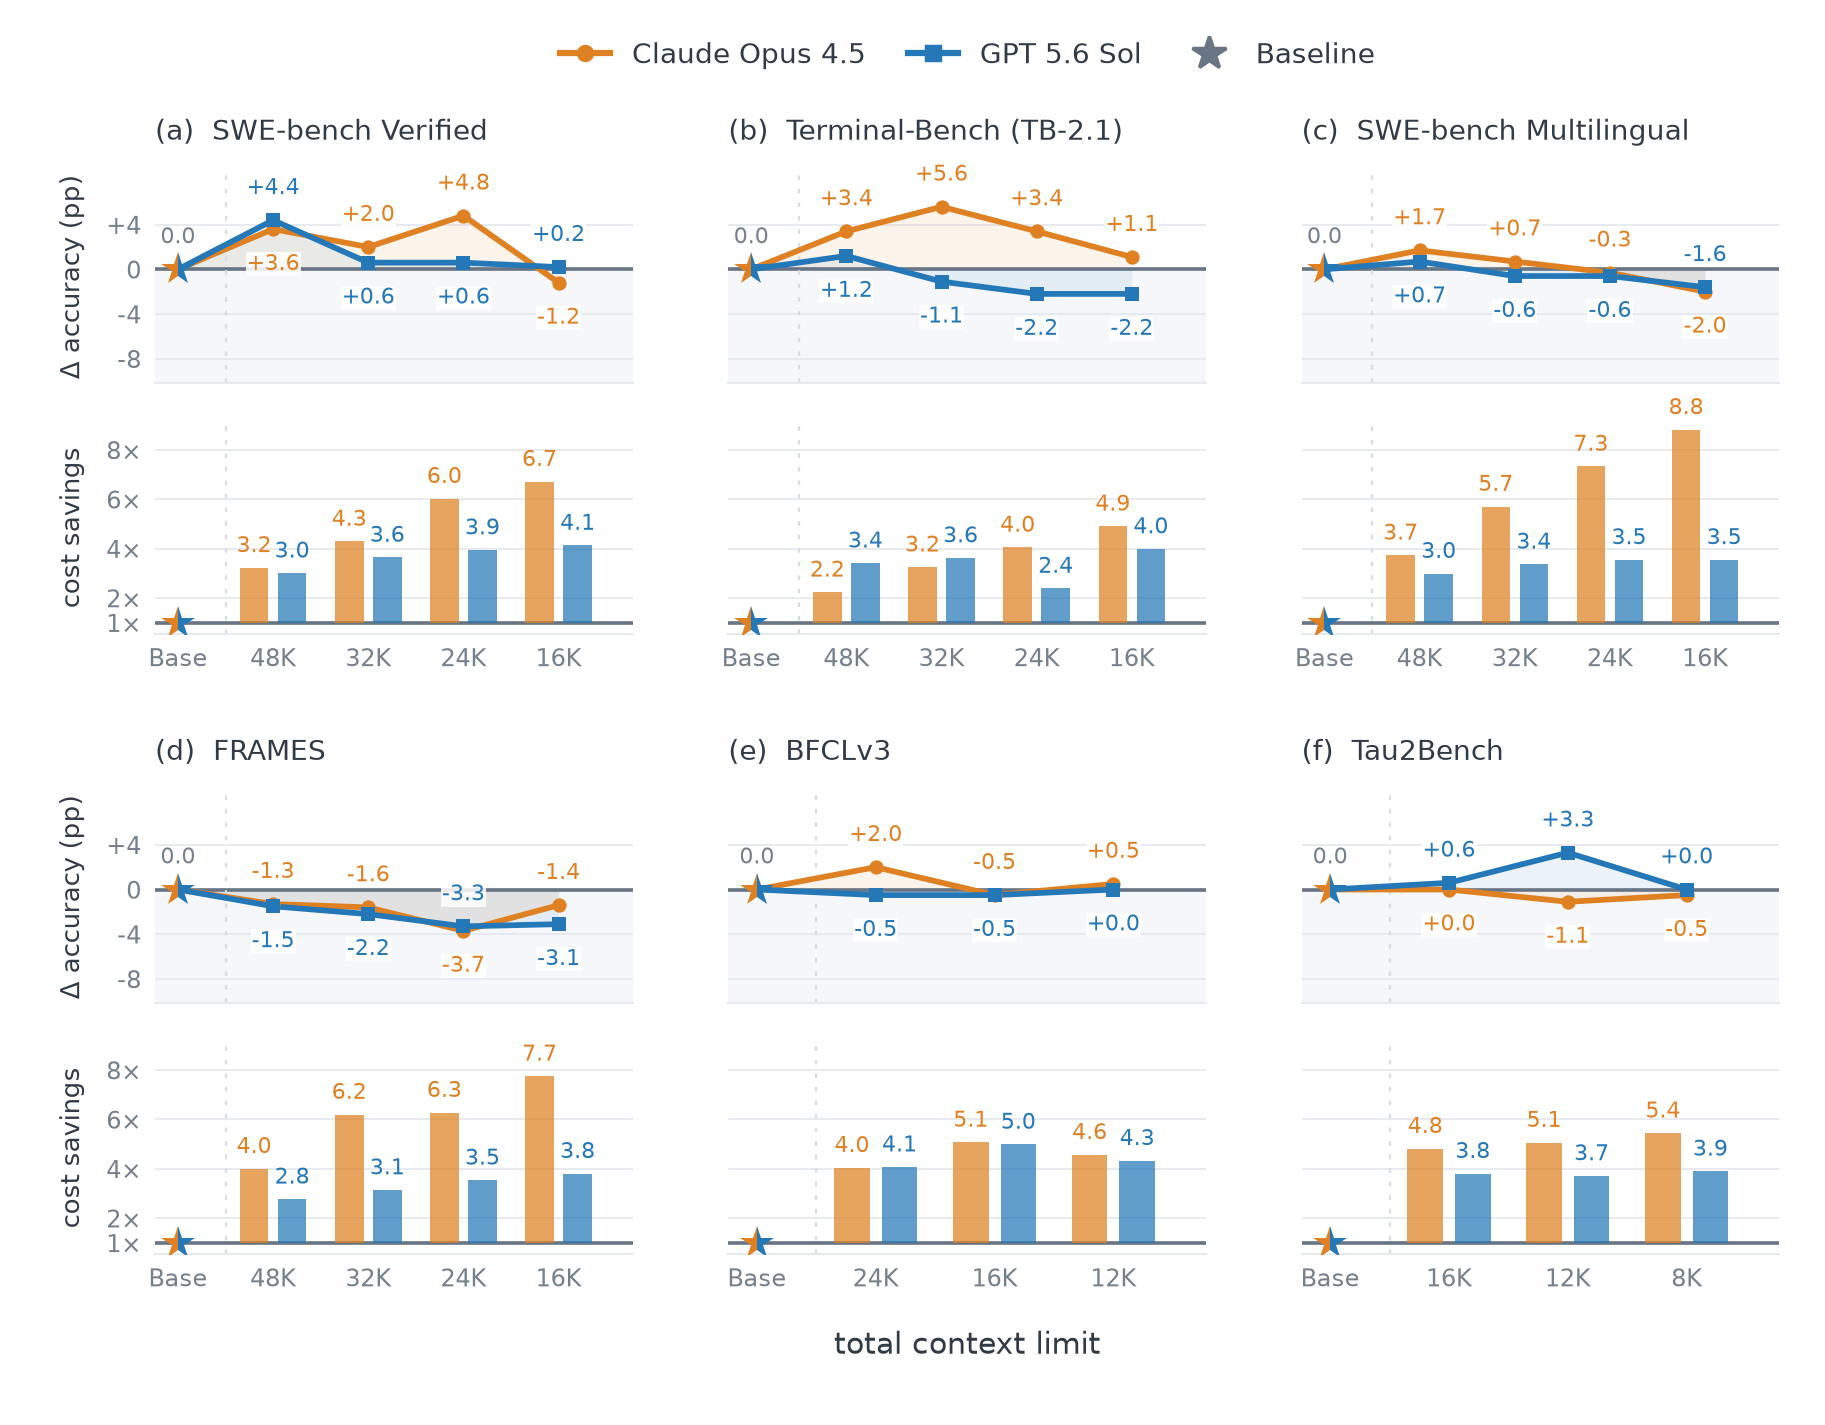
При обслуживании открытых моделей на ускорителях H100 расчётная стоимость генерации токена с контекстом в 256 тысяч токенов оказалась в 3,6–7 раз выше, чем с контекстом в 16 тысяч. Эта оценка основана на измеренной пропускной способности и стоимости аренды оборудования, а не на тарифах коммерческих API.
Авторы также описали концепцию моделей семантического пространства состояний — Semantic State Space Models, или SSSM. Такая модель после каждого действия обновляет краткое и понятное человеку описание состояния задачи, с которым работу может продолжить новый сеанс без полной истории предыдущих шагов.
Исследователи подчёркивают, что сжатие неизбежно приводит к потере части информации. Результаты не доказывают, что короткого контекста достаточно для любой задачи, но показывают, что хранение всей истории или загрузка всех исходных данных не всегда оправданы.
Источник: arxiv.org